AI en machine learning
Methodiek
Bluefin is gemaakt door ingenieurs, maar tot leven gebracht door Jacob Schnurr en Andy Frazer. Het artwork is gratis om te gebruiken en zal altijd door mensen worden gemaakt. Het is er om ons te herinneren dat open source een ecosysteem is dat in stand gehouden moet worden. De software die we maken heeft een effect op de wereld. Bluefin's AI-integratie zal altijd door de gebruiker worden bestuurd, met focus op open source-modellen en -tools.
Bluefin's focus in AI is het bieden van een generieke API-endpoint aan het besturingssysteem dat door de gebruiker wordt bestuurd. Net zoals Bluefin's besturingssysteem is opgebouwd met CNCF-technologie zoals bootc en podman, wordt deze ervaring aangedreven door Agentic AI Foundation-technologie zoals goose, met een sterke dosis open source-componenten die RHEL Lightspeed aandrijven.
AI-architectuur en -tools
Bluefin biedt open, door de gebruiker bestuurde API-endpoints aan het besturingssysteem voor AI-workflows. We doen dit via een door de community beheerde set aan toolaanbevelingen en -configuratie:
- “Bring your own LLM”-aanpak, het moet makkelijk zijn om tussen lokale en gehoste modellen te wisselen
- Goose als primaire interface naar gehoste en lokale modellen
- Versnelling van open standaarden in AI door tools te leveren van de Agentic AI Foundation, CNCF, en andere stichtingen
- Lokale LLM-servicebeheer
- Modelbeheer via
llmmanen Docker Model Runner, jouw keuze
- Modelbeheer via
- GPU-versnelling voor zowel Nvidia als AMD is standaard meegeleverd en vereist doorgaans geen extra setup
- Uitstekende AI/ML-toepassingen op Flathub belichten in onze samengestelde sectie in de App Store
- Een goede reden om meer merch te verkopen
Voor het deployen van reproduceerbare homelab- en multi-node AI/observability-infrastructuur, zie Bluespeed, Bluefin's homelab-fabriek aangedreven door KubeStellar, Flatcar, en Knuckle.
We werken nauw samen met het RHEL Lightspeed-team door hun code te leveren, feedback te geven en waar we kunnen de grens op te schuiven.
AI Lab met Podman Desktop
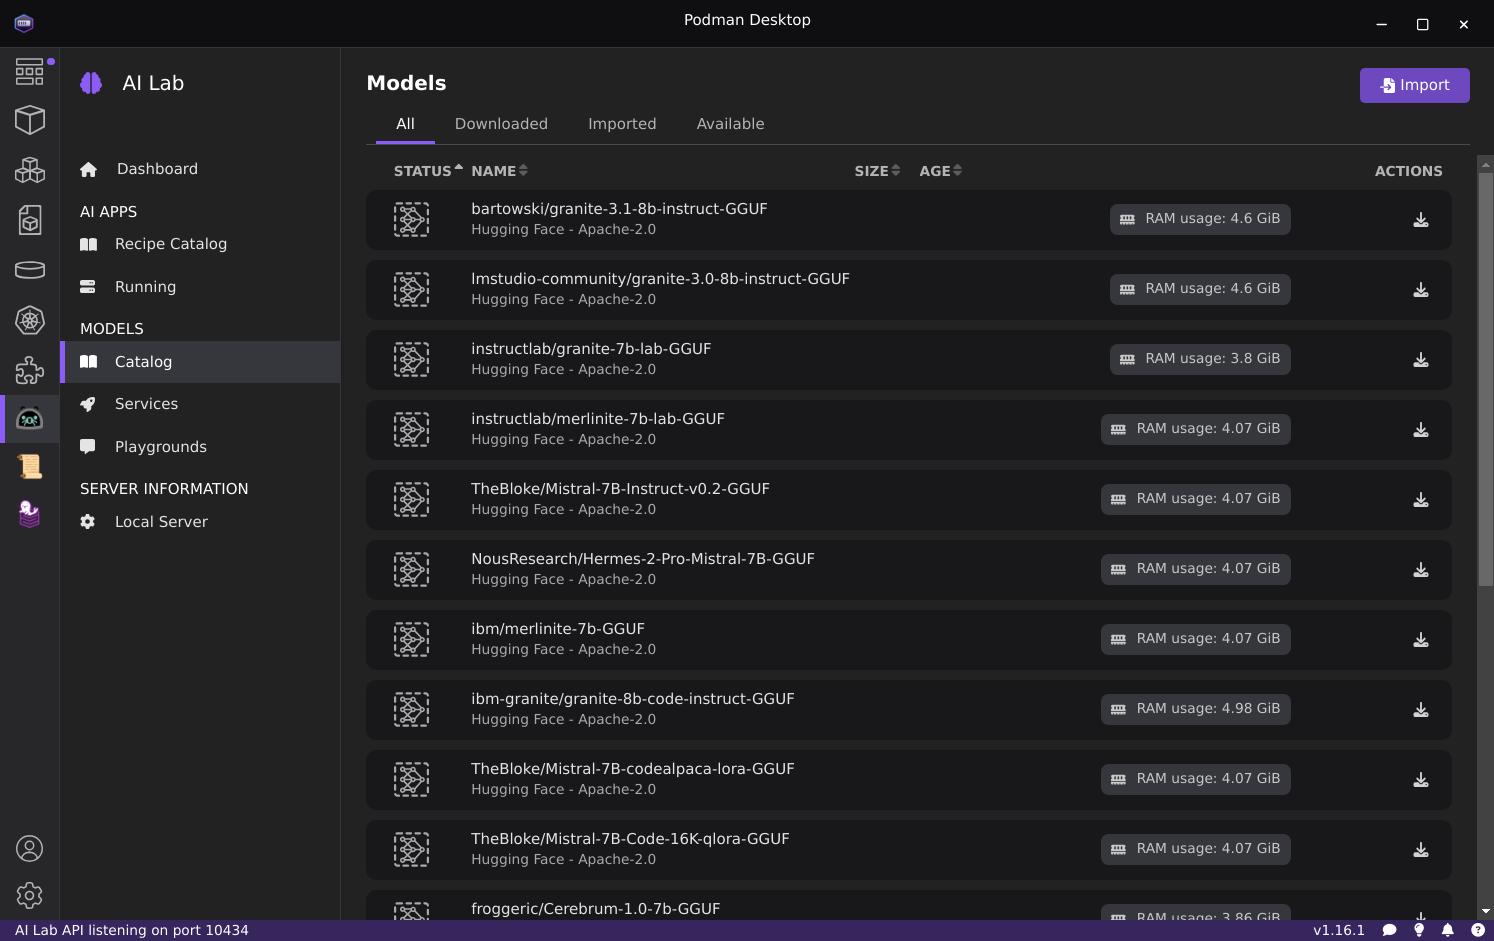
De AI Lab-extentie kan worden geïnstalleerd binnen de meegeleverde Podman Desktop om een grafische interface te bieden voor het beheer van lokale modellen:
AI-commandoregeltools
De volgende AI-gerichte commandoregeltools zijn beschikbaar via Homebrew (brew install <name>):
| Naam | Beschrijving |
|---|---|
| aichat | All-in-one AI-gedreven CLI Chat & Copilot |
| block-goose-cli | Block Protocol AI agent CLI |
| claude-code | Claude coding agent met desktopintegratie |
| codex | Code-editor voor OpenAI's coding agent die in je terminal draait |
| copilot-cli | GitHub Copilot CLI voor terminalassistent |
| crush | AI coding agent voor de terminal, van charm.sh |
| gemini-cli | Commandoregelinterface voor Google's Gemini API |
| kimi-cli | CLI voor Moonshot AI's Kimi-modellen |
| llm | Grote taalmodellen benaderen vanaf de commandoregel |
| lm-studio | Desktop-app om lokale LLM's te draaien |
| mistral-vibe | CLI voor Mistral AI-modellen |
| opencode | AI coding agent voor de terminal |
| qwen-code | CLI voor Qwen3-Coder-modellen |
| llmman | Beheer en draai AI-modellen lokaal met containers |
| whisper-cpp | Prestatiegericht infereren van OpenAI's Whisper-model |
llmman
Installeer llmman via brew install llmmanorg/tap/llmman: beheer lokale modellen en is de bij voorkeur standaardervaring. Het is voor mensen die vaak met lokale modellen werken en geavanceerde functies nodig hebben. Het biedt de mogelijkheid om modellen te trekken van huggingface, ollama, en elke containerregistry. Zie de llmman-documentatie voor meer information.
Gebruik het volledige llmman-command in Bluefin, overeenkomstig de upstream llmman-documentatie.
De commandoregelervaring van llmman omvat:
llmman pull llama3.2:latest
llmman run llama3.2
llmman run deepseek-r1
Je kan de modellen ook lokaan serveren:
llmman serve
Ga daarna naar http://127.0.0.1:17434 in je browser.
Integreren met bestaande tools
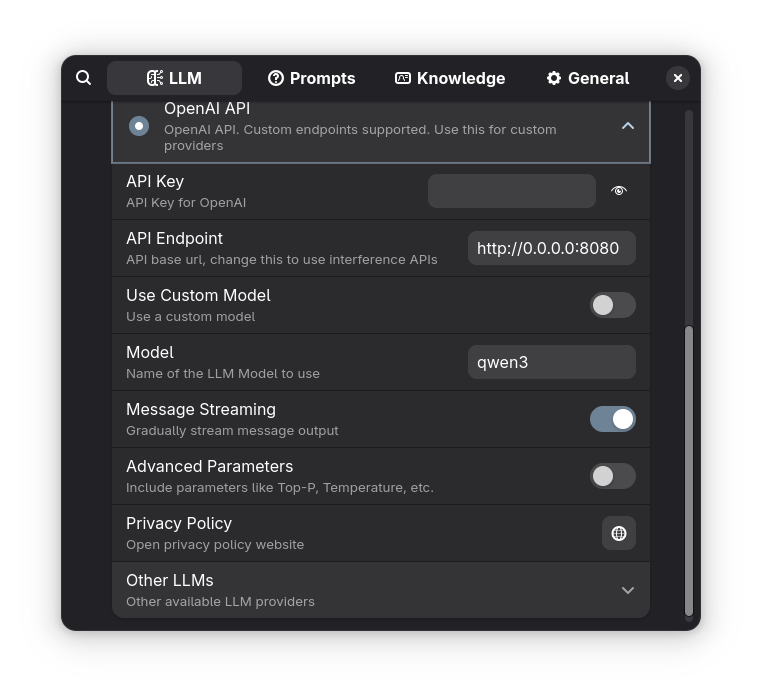
llmman serve servert een OpenAI-compatible endpoint op http://127.0.0.1:17434, je kan dit gebruiken om tools te configureren die llmman niet rechtstreeks ondersteunen:
AI-agents draaien in VS Code
Hier is een voorbeeld van het gebruik van devcontainers om agents binnen containers te draaien voor isolatie:
Docker Model Runner
Docker Model Runner is Docker's ingebouwde lokale LLM-service, meegeleverd in Bluefin naast llmman. Het draait modellen uit Docker Hub's AI catalogus en biedt aan een OpenAI-compatible API — geen aparte serversetup nodig.
Basisgebruik
# Pull a model from Docker Hub
docker model pull ai/llama3.2

# Run a model interactively
docker model run ai/llama3.2

# List downloaded models
docker model ls

# Remove a model
docker model rm ai/llama3.2
API-endpoint
Docker Model Runner servert een OpenAI-compatible endpoint op http://localhost:12434 dat je met elke tool kan gebruiken die de OpenAI-API-formaat ondersteunt — Goose, aichat, VSCode-extenties, en meer.
llmman vs Docker Model Runner
Beide bieden een lokale OpenAI-compatible API. Kies op basis van je workflow:
| llmman | Docker Model Runner | |
|---|---|---|
| Modelbronnen | OCI-registers, Ollama, HuggingFace | Docker Hub AI catalogus |
| Engine | Podman | Docker Engine |
| Snelle comm. | llmman | docker model |
Zie de Docker Model Runner-documentatie voor de volledige modelcatalogus en configuratieopties.
Alpaca grafische client
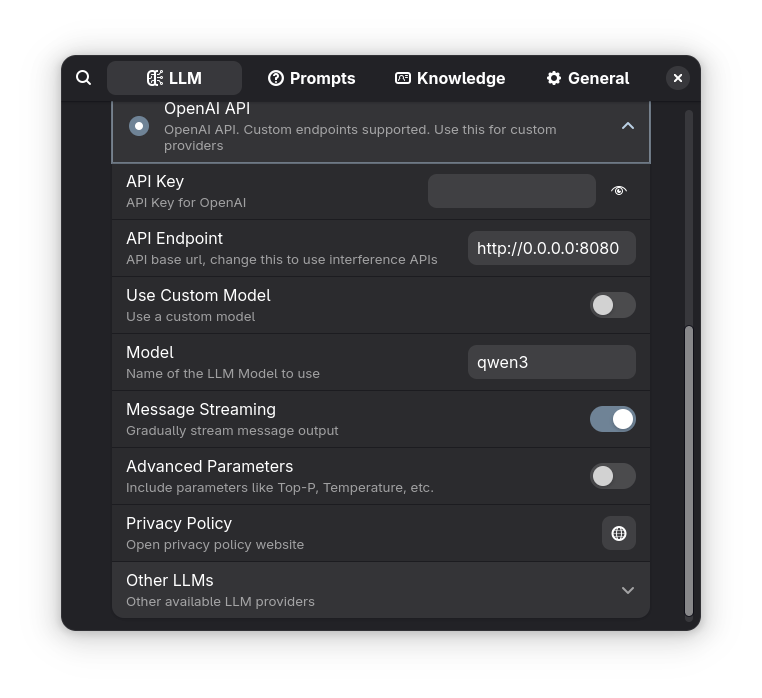
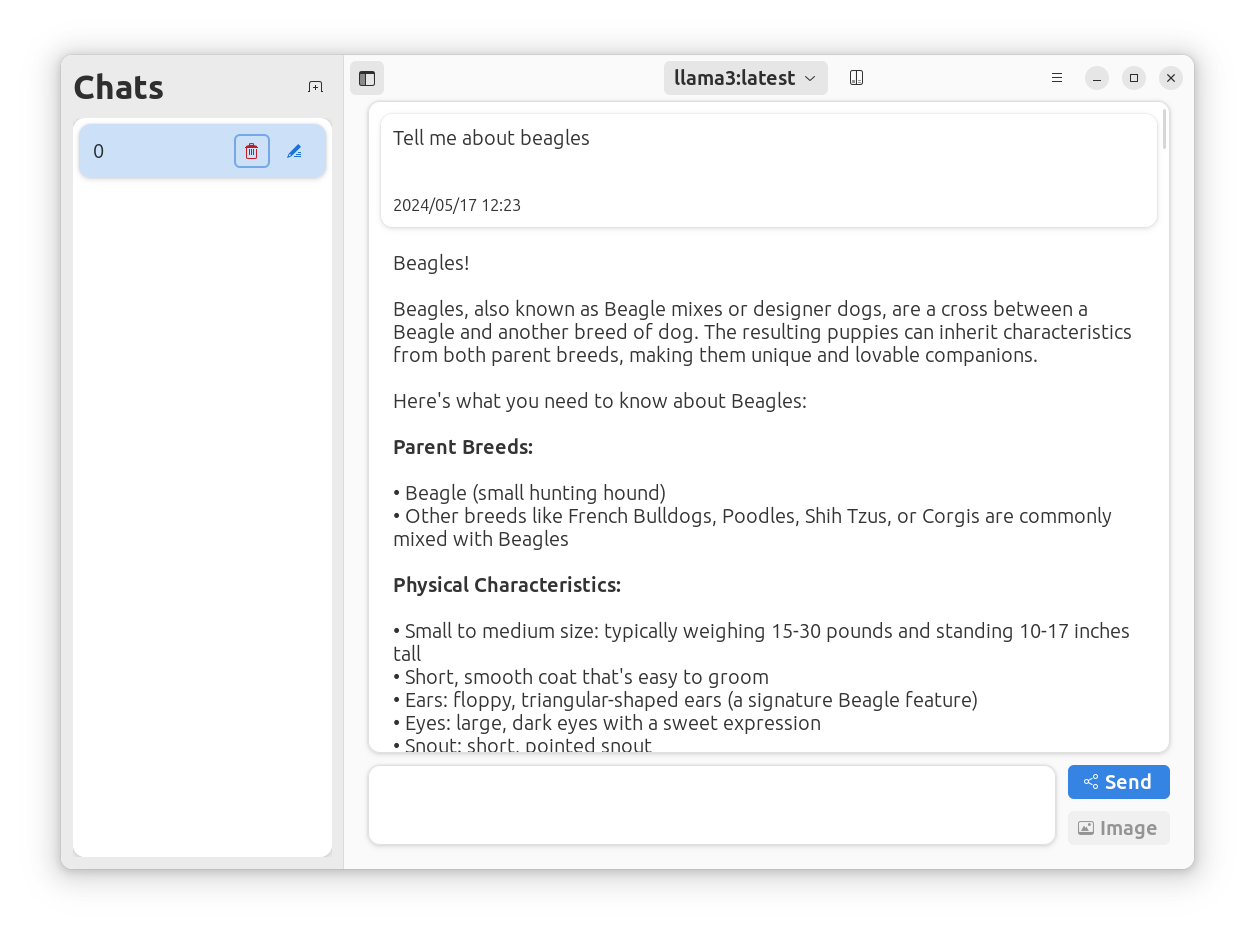
Voor licht chatbot-gebruik aanbevolen we dat gebruikers Alpaca installeren om hun LLM-modellen te beheeren en te chatten vanuit een native desktop-app. Alpaca ondersteunt Nvidia en AMD1-versnelling natively.
Bluefin bindt Ctrl-Alt-Backspace als quicklaunch voor Alpaca automatisch nadat je het geïnstalleerd hebt!
Configuratie
Geautomatiseerd probleemoplossen (WIP)
Bluefin levert geautomatiseerde probleemoplossingstools:


