KI und Maschinelles Lernen
Methodik
Bluefin wurde von Ingenieuren entwickelt, aber zum Leben erweckt von Jacob Schnurr und Andy Frazer. Die Grafiken stehen dir kostenlos zur Verfügung und werden immer von Menschen gemacht. Sie sollen uns daran erinnern, dass Open Source ein Ökosystem ist, das gepflegt werden muss. Die Software, die wir machen, hat eine Wirkung auf die Welt. Bluefins KI-Integration wird immer nutzergesteuert sein, mit Fokus auf Open-Source-Modelle und -Tools.
Bluefins Fokus in der KI liegt darauf, einen generischen API-Endpunkt zum Betriebssystem bereitzustellen, der vom Nutzer kontrolliert wird. Genau wie Bluefins Betriebssystem mit CNCF-Technologie wie bootc und podman gebaut ist, wird diese Erfahrung durch Technologie der Agentic AI Foundation wie goose betrieben. Mit einer kräftigen Prise der Open-Source-Komponenten, die RHEL Lightspeed antreiben.
KI-Architektur und Tooling
Bluefin stellt offene, nutzergesteuerte API-Endpunkte zum Betriebssystem für KI-Workflows bereit. Wir tun dies über einen von der Community verwalteten Satz von Tool-Empfehlungen und Konfiguration:
- „Bring your own LLM“-Ansatz, es sollte einfach sein, zwischen lokalen und gehosteten Modellen zu wechseln
- Goose als primäre Schnittstelle zu gehosteten und lokalen Modellen
- Beschleunigung offener Standards in der KI durch das Ausliefern von Tools von der Agentic AI Foundation, CNCF und anderen Stiftungen
- Verwaltung lokaler LLM-Dienste
- Modellverwaltung via
llmmanund Docker Model Runner, deine Wahl
- Modellverwaltung via
- GPU-Beschleunigung für sowohl Nvidia als auch AMD ist standardmäßig enthalten und erfordert normalerweise keine zusätzliche Einrichtung
- Hervorhebung großartiger KI/ML-Anwendungen auf Flathub in unserem kuratierten Bereich im App Store
- Ein großartiger Grund, mehr Swag zu verkaufen
Für die Bereitstellung reproduzierbarer Homelab- und Multi-Node-KI/Observability-Infrastruktur siehe Bluespeed, Bluefins Homelab-Factory, betrieben mit KubeStellar, Flatcar und Knuckle.
Wir arbeiten eng mit dem RHEL-Lightspeed-Team zusammen, indem wir deren Code ausliefern, Feedback geben und die Grenzen ausloten wo wir können.
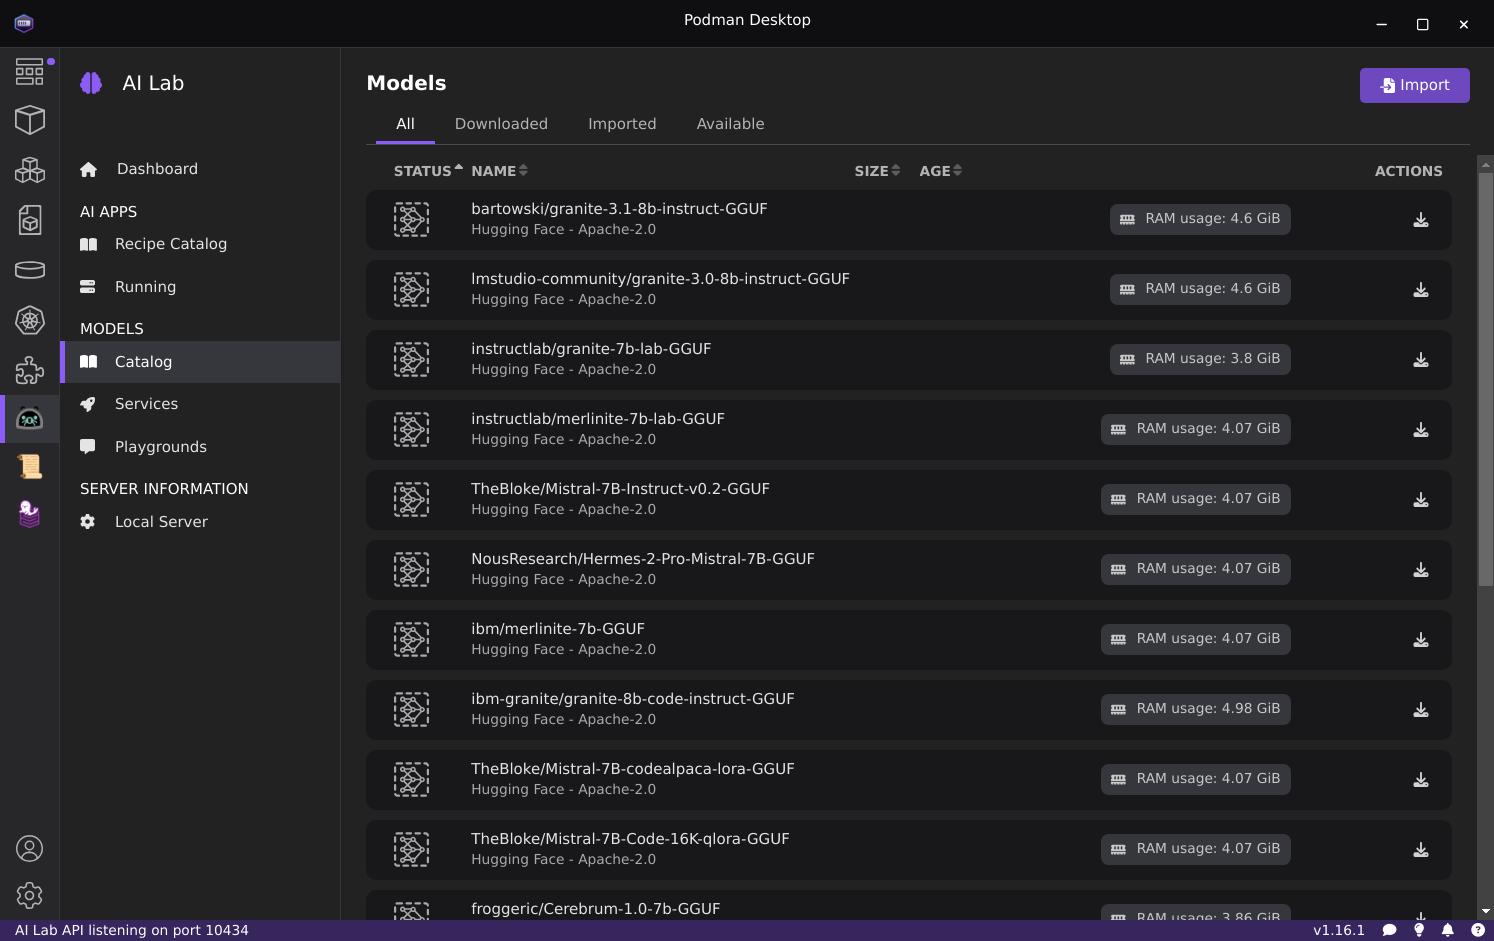
KI-Lab mit Podman Desktop
Die AI-Lab-Erweiterung kann im enthaltenen Podman Desktop installiert werden, um eine grafische Oberfläche zur Verwaltung lokaler Modelle bereitzustellen:
KI-Befehlszeilen-Tools
Die folgenden KI-fokussierten Befehlszeilen-Tools sind via Homebrew verfügbar (brew install <name>):
| Name | Beschreibung |
|---|---|
| aichat | All-in-One-KI-gestützte CLI-Chat- und Copilot-App |
| block-goose-cli | Block Protocol KI-Agent-CLI |
| claude-code | Claude-Coding-Agent mit Desktop-Integration |
| codex | Code-Editor für OpenAIs Coding-Agent, der in deinem Terminal läuft |
| copilot-cli | GitHub-Copilot-CLI für Terminal-Unterstützung |
| crush | KI-Coding-Agent für das Terminal, von charm.sh |
| gemini-cli | Befehlszeilen-Schnittstelle für Googles Gemini-API |
| kimi-cli | CLI für Moonshot AIs Kimi-Modelle |
| llm | Zugriff auf große Sprachmodelle von der Befehlszeile |
| lm-studio | Desktop-App zum Ausführen lokaler LLMs |
| mistral-vibe | CLI für Mistral-AI-Modelle |
| opencode | KI-Coding-Agent für das Terminal |
| qwen-code | CLI für Qwen3-Coder-Modelle |
| llmman | KI-Modelle lokal mit Containern verwalten und ausführen |
| whisper-cpp | Hochleistungs-Inferenz von OpenAIs Whisper-Modell |
llmman
Installiere llmman via brew install llmmanorg/tap/llmman: verwalte lokale Modelle und ist die bevorzugte Standarderfahrung. Es ist für Leute, die häufig mit lokalen Modellen arbeiten und erweiterte Funktionen benötigen. Es bietet die Möglichkeit, Modelle von Huggingface, Ollama und jeder Container-Registry zu pullen. Sieh in die llmman-Dokumentation für weitere Informationen.
Verwende den vollständigen llmman-Befehl in Bluefin, passend zur Upstream-llmman-Dokumentation.
llmmans Befehlszeilen-Erfahrung umfasst:
llmman pull llama3.2:latest
llmman run llama3.2
llmman run deepseek-r1
Du kannst die Modelle auch lokal bereitstellen:
llmman serve
Gehe dann in deinem Browser zu http://127.0.0.1:17434.
Integration mit bestehenden Tools
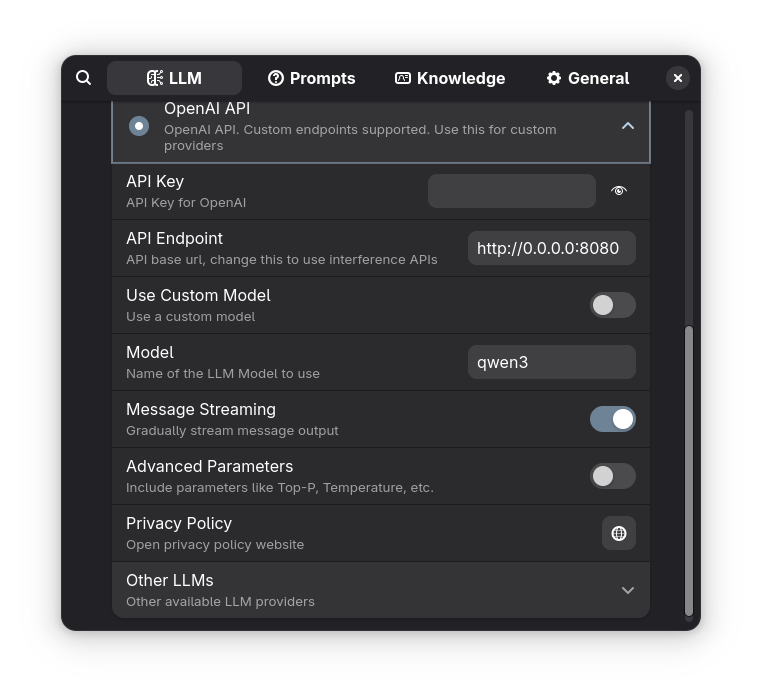
llmman serve stellt einen OpenAI-kompatiblen Endpunkt unter http://127.0.0.1:17434 bereit; du kannst dies verwenden, um Werkzeuge zu konfigurieren, die llmman nicht direkt unterstützen:
KI-Agenten in VS Code ausführen
Hier ist ein Beispiel für die Verwendung von Devcontainern, um Agenten innerhalb von Containern zur Isolierung auszuführen:
Docker Model Runner
Docker Model Runner ist Dockers eingebauter lokaler LLM-Dienst, der in Bluefin neben llmman enthalten ist. Er führt Modelle aus dem AI-Katalog von Docker Hub aus und stellt eine OpenAI-kompatible API bereit — keine separate Server-Einrichtung erforderlich.
Grundlegende Verwendung
# Pull a model from Docker Hub
docker model pull ai/llama3.2

# Run a model interactively
docker model run ai/llama3.2

# List downloaded models
docker model ls

# Remove a model
docker model rm ai/llama3.2
API-Endpunkt
Docker Model Runner stellt einen OpenAI-kompatiblen Endpunkt unter http://localhost:12434 bereit, den du mit jedem Tool verwenden kannst, das das OpenAI-API-Format unterstützt — Goose, aichat, VSCode-Erweiterungen und mehr.
llmman vs. Docker Model Runner
Beide bieten eine lokale OpenAI-kompatible API. Wähle basierend auf deinem Workflow:
| llmman | Docker Model Runner | |
|---|---|---|
| Modellquellen | OCI-Registries, Ollama, HuggingFace | Docker Hub AI-Katalog |
| Engine | Podman | Docker Engine |
| Schnellbefehl | llmman | docker model |
Sieh in die Docker Model Runner-Dokumentation für den vollständigen Modellkatalog und die Konfigurationsoptionen.
Alpaca Grafischer Client
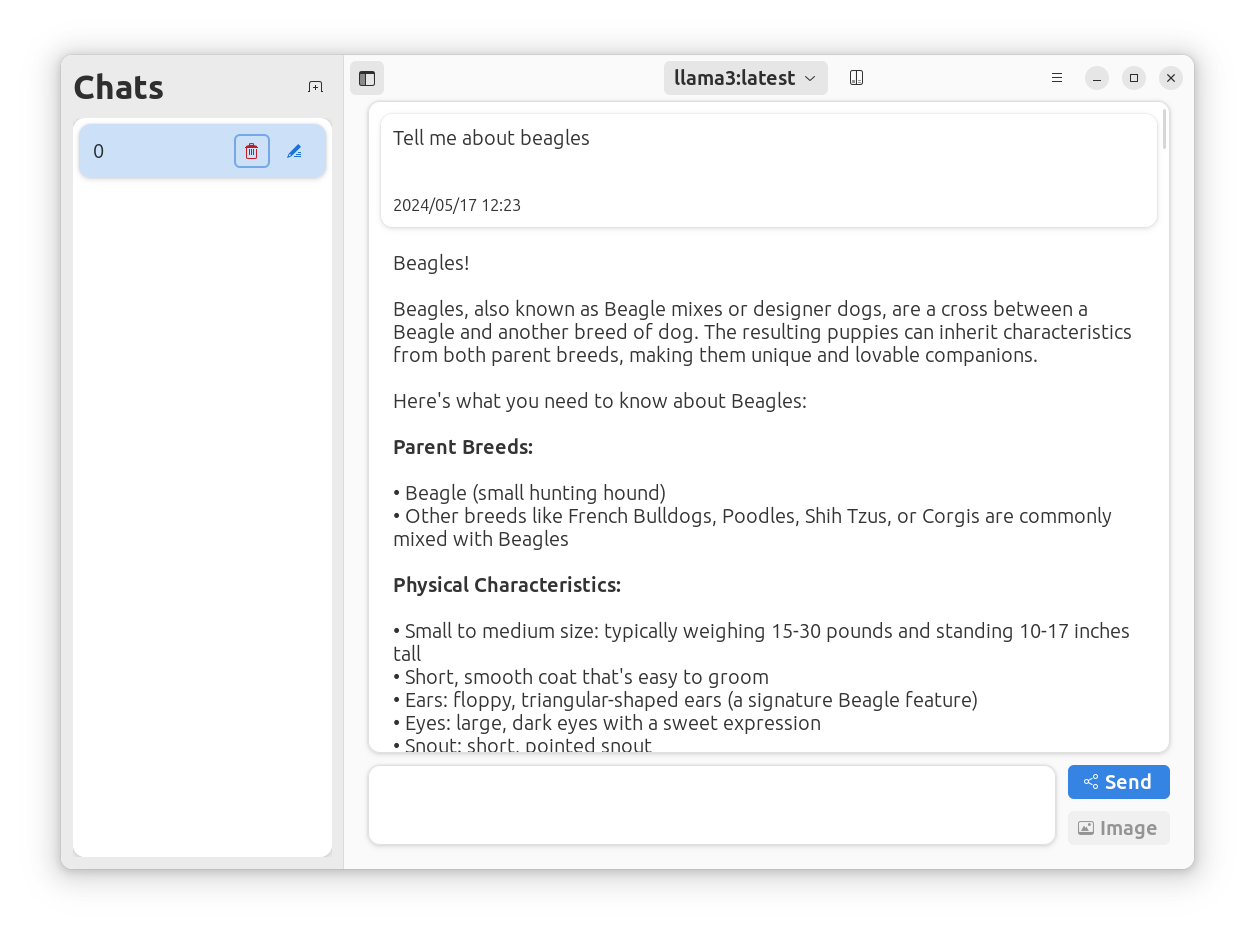
Für leichte Chatbot-Nutzung empfehlen wir, dass Nutzer Alpaca installieren, um ihre LLM-Modelle aus einer nativen Desktop-Anwendung heraus zu verwalten und mit ihnen zu chatten. Alpaca unterstützt Nvidia- und AMD1-Beschleunigung nativ.
Bluefin bindet Ctrl-Alt-Backspace als Schnellstart für Alpaca, nachdem du es installiert hast!
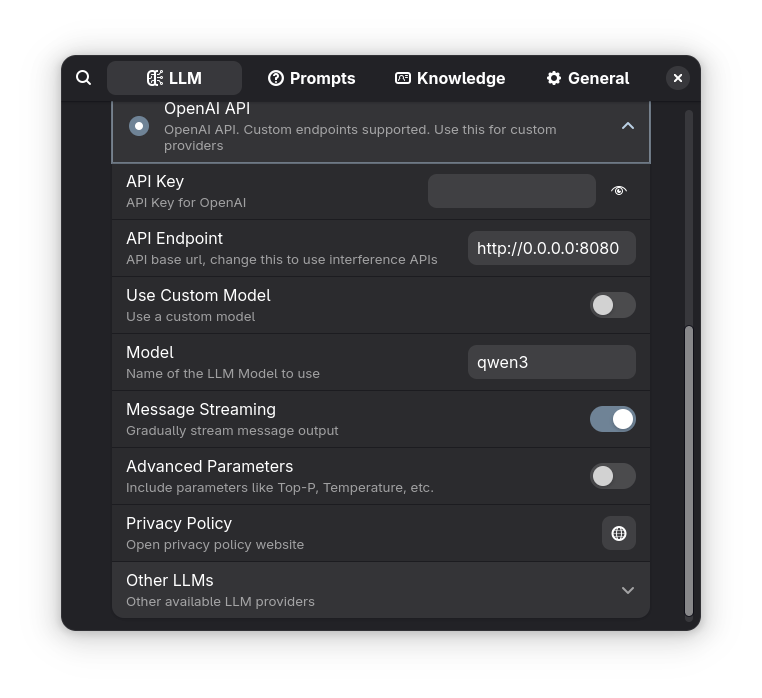
Konfiguration
Automatisierte Fehlerbehebung (WIP)
Bluefin wird mit automatisierten Fehlerbehebungs-Tools ausgeliefert:


